如何连续两年获得 IEEE ICRA 全球机器人挑战赛冠军 🏆
过去两年,我带着团队连续拿下了两个不同领域的 IEEE ICRA 全球机器人挑战赛冠军。
第一个是 ICRA 2025 Earth Rover Challenge 2,一个 autonomous navigation 方向的全球机器人挑战赛。主办方把 low-cost robot 小车部署在全球七个国家,我们需要远程让机器人在没有人工介入的情况下完成几公里级别的全自主导航。这个任务最难的地方不是某个单点算法,而是极强的泛化要求:机器人传感器非常有限,主要只有 RGB camera 和非常 noisy 的 GPS;但它要面对的是不同国家、不同道路、不同光照、不同地形和不同城市结构。
第二个是 ICRA 2026 REAL-I Challenge,一个更接近真实工业场景的 manipulation 挑战赛。任务包括物流分拣、汽车零部件上下料、日化品上下料,需要基于主办方提供的数据训练双臂或类人操作策略,并最终在真实场景中完成任务。它的核心挑战也很明确:不能无限采集新数据,不能只在 simulator 里验证,最后必须在真实机器人上稳定工作。
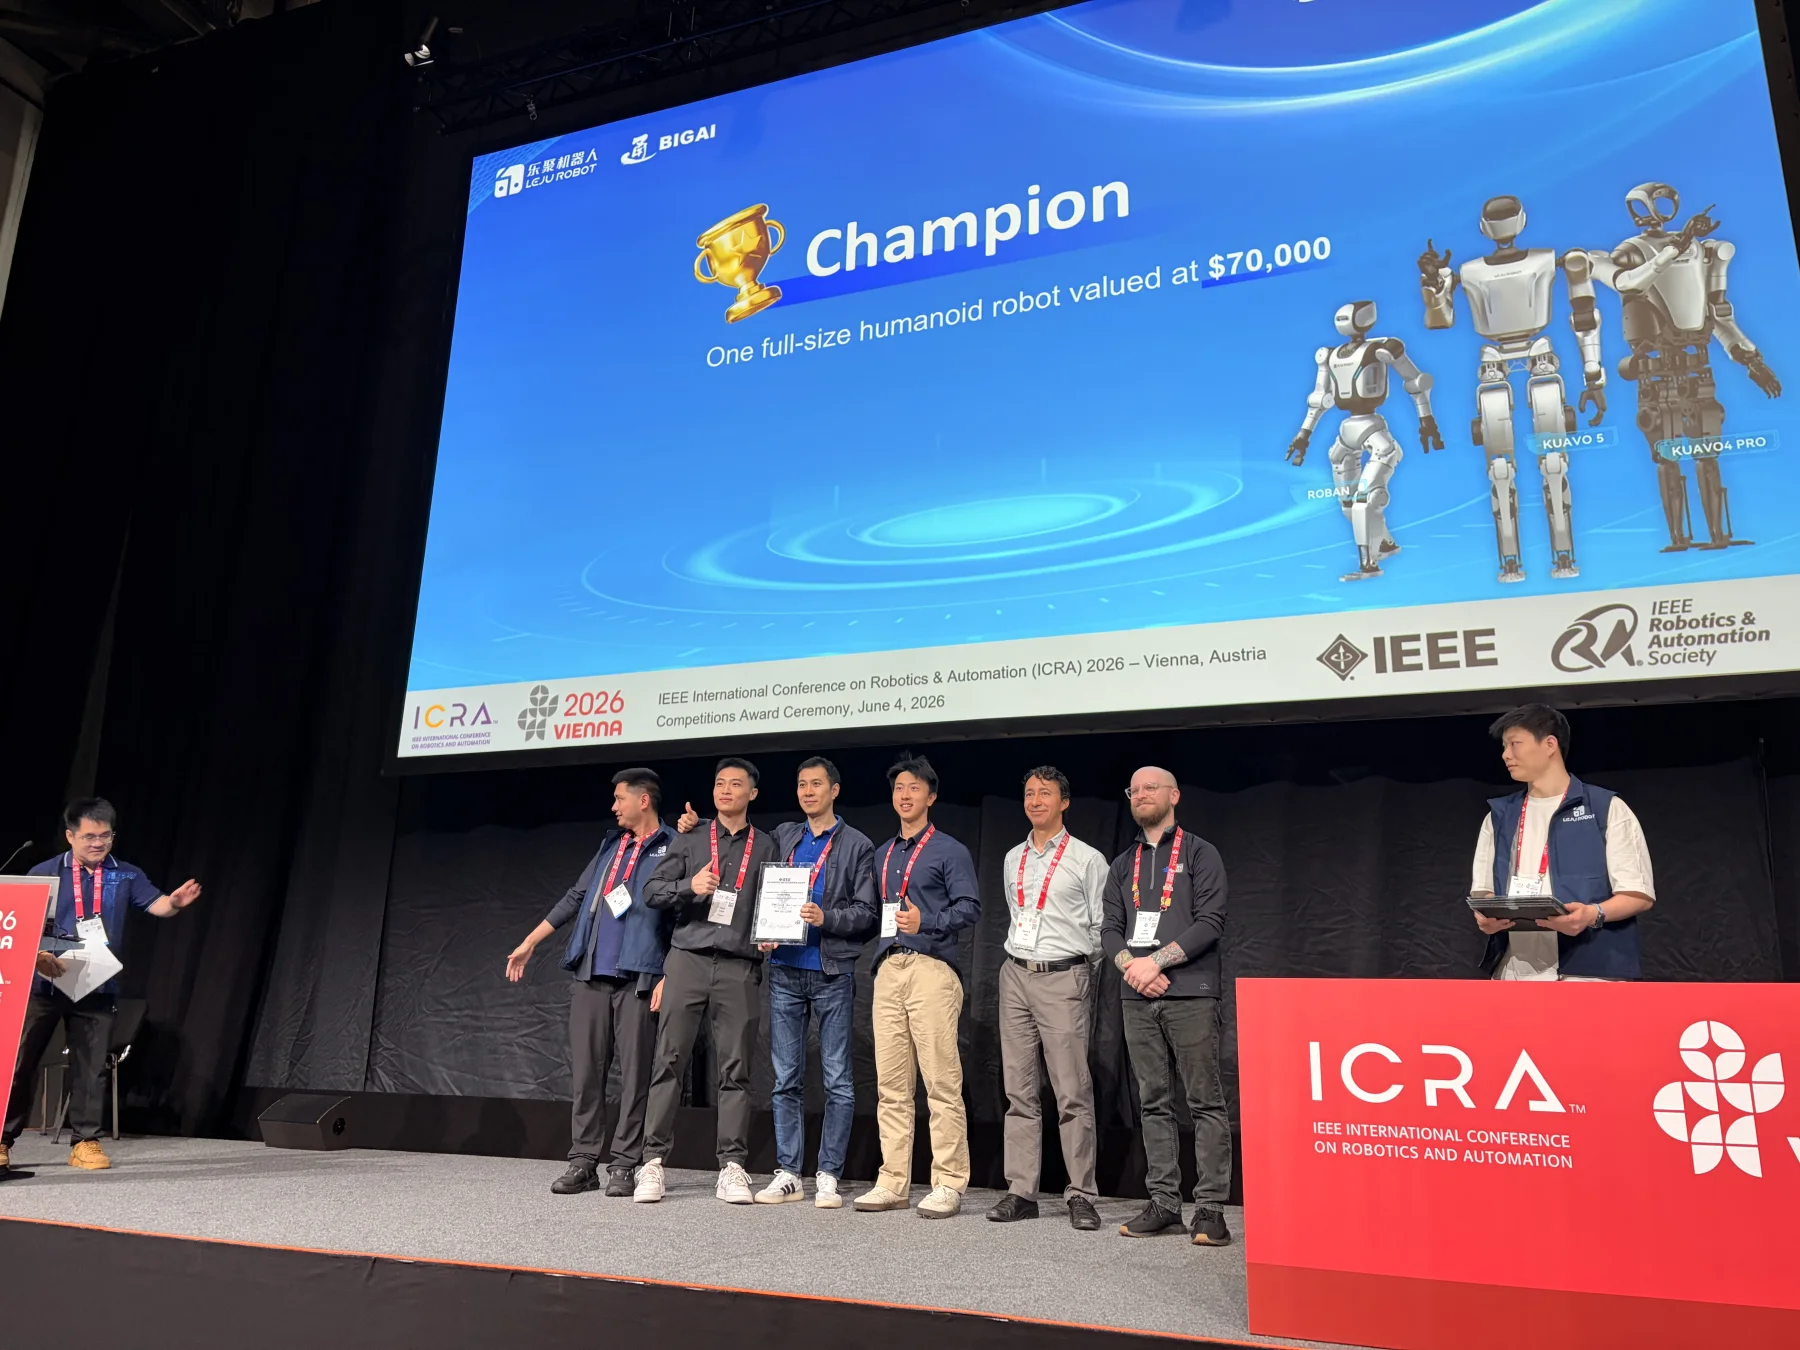
这两个比赛方向完全不同,一个是开放环境里的长距离导航,一个是真实工业场景里的双臂操作;一个更考验 perception、planning 和 robustness,另一个更考验 data、policy learning 和 generalization。但回头看,真正帮助我们连续两年获胜的,并不是某一个具体模型,也不是某个特别新的方法,而是两个更底层的判断:
- 不要从方法出发,而要从问题出发。
- 从问题出发之后,要用第一性原理把问题拆到最基本的目标、约束和瓶颈,再决定方法。
这两点听起来简单,但在真实机器人任务里非常重要。因为机器人系统的失败,往往不是因为“没有用最新模型”,而是因为一开始没有判断清楚真正的瓶颈在哪里。一个方法再先进,如果它解决的不是当前任务里最关键的问题,就很难带来实际收益;相反,一个看起来不那么 fancy 的组合,只要准确击中任务约束,往往会比更复杂的端到端方案更有效。
一、先从问题出发,而不是从方法出发
现在机器人领域有非常多不同的方法:操作领域有 WAM、VLA、Diffusion Policy 等,navigation 领域有 NoMaD 等 VLN end-to-end 模型、SLAM 建图导航、optimization-based planning 等,每个方向都有非常值得研究的地方。但真实比赛和真实落地不是方法展示,而是约束下的问题求解。
如果一开始就问“我要不要用 VLA”“我要不要用 Diffusion Policy”“我要不要用 SLAM”,其实已经把顺序反了。更合理的起点应该是:这个任务真正要求机器人完成什么?当前有哪些硬约束?失败最可能发生在哪里?哪些因素真正决定最终表现?
只有先把问题看清楚,方法选择才有意义。否则很容易出现一种情况:方法本身很先进,但它解决的是一个并非当前核心瓶颈的问题。比如一个模型在 benchmark 上很强,并不代表它适合有限数据下的真实工业操作;一个 SLAM pipeline 在标准场景里很完整,也不代表它能在低成本硬件、单目 RGB、noisy GPS 和开放道路环境下稳定支撑几公里导航。
所以第一步一定是问题导向:先不要急着选模型,先把任务本身拆清楚。方法应该是问题分析之后的结果,而不是问题分析之前的预设。
二、问题导向之后,怎么拆?用第一性原理
问题导向解决的是“从哪里开始”的问题;第一性原理解决的是“怎么往下拆”的问题。
所谓第一性原理,在机器人任务里不是一句抽象口号,而是把问题拆到最基本的目标、输入、约束和误差来源:系统最终要优化什么?可用信息是什么?不可控变量是什么?主要误差来自哪里?模型需要学到什么?哪些环节需要泛化,哪些环节需要稳定和可控?
当问题被拆到这个层面,很多方法选择会变得非常清楚。你不再是在各种热门方法之间做主观选择,而是在判断:这个方法是否正好解决了当前任务的关键瓶颈。
三、REAL-I:从问题出发,核心是有限数据下的可泛化操作策略
以 REAL-I Challenge 为例。如果从方法出发,很容易一上来就讨论要不要用 VLA、要不要用 Diffusion Policy、要不要直接 fine-tune 某个大模型。但如果从问题出发,这个比赛首先是一个非常明确的有限数据学习问题:主办方提供数据,我们需要在不能随意增加新数据的情况下,让模型学会真实工业场景中的操作策略,并且最终在真实机器人上稳定执行。
用第一性原理继续往下拆,这个问题的核心瓶颈不是“模型名字是什么”,而是三个更基础的问题:数据质量、数据的信息密度,以及模型 capacity 和 generalization 的平衡。
第一是数据质量。真实机器人数据,尤其是人类示教数据,天然会有噪声。里面可能有过长轨迹、过短轨迹、不稳定操作、动作不一致、边缘成功样本,甚至有些 demo 虽然最终完成了任务,但中间过程并不适合模型学习。如果这些数据不处理,模型很可能不是在学习任务结构,而是在记忆噪声。对于有限数据任务来说,低质量样本的伤害会被进一步放大,因为它不仅占用训练容量,还会影响模型对动作分布的判断。因此,数据筛选、轨迹分析和质量控制不是辅助工作,而是任务本身的核心部分。
第二是信息密度。比赛要求使用主办方提供的数据,这意味着不能简单依靠“再采更多数据”来提高性能。但数据量不能增加,不代表有效信息量不能增加。同样一段 RGB 轨迹,如果只用来做 action imitation,模型获得的是一层监督信号;如果结合 depth alignment、几何先验,或者利用其他模型的 prior 给训练过程提供额外结构约束,模型就有机会从同一份数据里学到更多空间关系和任务结构。换句话说,当数据数量被固定时,真正应该优化的是每条数据里可被模型利用的信息量。
第三是模型 capacity 和 generalization 的平衡。模型太小,可能吸收不了复杂的视觉和动作映射;模型太大,或者训练约束不够,又可能在有限数据上过拟合。真实机器人任务和 simulator 最大的区别就在这里:在仿真里表现接近的方法,到了真实场景里可能差距很大,因为真实部署会引入视觉偏移、物体位姿误差、执行误差和长时序累积误差。因此,模型选择的重点不是“哪个方法最流行”,而是它是否既有足够 capacity 学到任务,又能在有限数据下保持泛化能力。
所以在 REAL-I 里,我们真正关心的不是“是否用了某个最新模型”,而是围绕这三个瓶颈做技术决策:如何去掉会伤害训练的样本,如何提高同一份数据的信息密度,如何让预训练模型适应当前工业任务,同时尽量保留它原本的泛化能力,如何避免模型只记住训练轨迹,而是学到更稳定的空间和任务结构。
这就是问题导向和第一性原理的关系:先从比赛任务本身出发,识别出这是一个有限数据下的真实机器人泛化问题;再从第一性原理拆出数据质量、信息密度、模型泛化这几个关键变量;最后,所有方法选择都围绕这些变量展开。
四、ERC:从问题出发,核心是开放环境下的泛化问题
ICRA 2025 Earth Rover Challenge 2 是另一个完全不同的例子。它看起来是 navigation,但如果只把它理解成“导航问题”,还不够准确。更本质地说,这是一个弱传感器、长距离、开放环境下的可靠决策问题。
机器人硬件成本低,传感器非常有限,主要只有 RGB camera 和 noisy GPS;但它需要在全球七个国家的真实环境中完成几公里级别导航。这个任务的关键不只是“会不会规划路径”,而是系统能否在感知不完整、定位不稳定、环境差异极大的情况下,持续做出足够可靠的局部决策。
如果从方法出发,常见选择有两类。
第一类是 end-to-end learning。比如使用类似 NoMaD 的视觉导航方法,让模型直接从视觉输入预测导航行为。这类方法很有吸引力,也符合 learning-based robotics 的趋势。但从第一性原理看,它隐含了一个前提:我们有足够多、足够高质量、覆盖足够广环境分布的数据,让模型学到强泛化的导航策略。而在这个比赛里,数据本身 noisy,环境跨度又大,这个前提并不充分。我们的实验也验证了这一点:直接训练或迁移一个端到端 navigation model,在当前约束下并不稳定。
第二类是 classical SLAM + planning。这是传统机器人导航里很自然的路线:先建图、再定位、再规划。但它同样有自己的前提:需要足够可靠的几何感知、可用的地图质量,以及足够低的系统延迟。对于这个比赛里的 low-cost robot 和单目 RGB 输入,这些条件也很难满足。我们做了大量实验后发现,系统 latency 会影响实时决策,而单目相机在开放环境中构建出的地图质量,也不足以支撑稳定 planning。理论上的 pipeline 很完整,但底层假设和实际约束并不匹配。
最后,我们选择了一个更符合任务约束的组合:用学习模型做 traversability prediction,再结合 classical optimization-based planner 做路径规划。学习模块不直接承担完整导航策略,而是回答一个更基础的问题:当前视觉输入下,哪里更可能可通行,哪里风险更高。规划模块则在这个中间表征上做稳定、可控、可解释的决策。
这个方案不是纯 learning,也不是纯 classical,但它更准确地对应了问题本身。弱传感器条件下,直接端到端学习完整策略的数据需求太高;完全依赖 SLAM 又需要更可靠的几何输入;而 traversability prediction 把问题拆成了一个更适合学习的中间任务,再把长期决策交给 planner。这不是为了折中而折中,而是从任务约束出发后自然得到的系统设计。
这也说明,真实机器人系统里,learning 和 classical methods 并不是非此即彼。关键不是选择阵营,而是判断系统中哪一部分需要学习的泛化能力,哪一部分需要传统方法的稳定性和可控性。
五、有效的 literature review,是建立问题地图,而不是收集方法
要做到问题导向,仅靠直觉是不够的。一个很重要的能力,是通过 literature review 建立问题地图,而不是简单收集方法。
很多人读论文是线性的:看到一篇方法不错,就想试一下;又看到一个新模型,就觉得也许可以用。但如果目标是真实机器人任务,这种方式很容易被单个方法牵着走。更有效的方式是先把问题空间结构化,再把方法放进去比较。
比如 navigation 任务,可以先把方法分成 classical SLAM + planning、end-to-end learning、learned traversability + planner、topological navigation、GPS-based routing 等类别。然后逐一分析每类方法的前提:它依赖什么传感器,需要什么数据质量,对 latency 有什么要求,在真实环境里的 failure mode 是什么,和当前任务约束是否匹配。
manipulation 也是一样。不能只看到 VLA、Diffusion Policy 或某个最新 policy 就直接开始实验,而是要先把问题拆成数据质量、数据规模、信息密度、模型 capacity、泛化能力、动作表示、视觉表示、几何先验、真实部署误差和长时序稳定性。然后再判断不同方法分别解决哪个维度,又在哪些维度上可能失效。
这样做的好处是,技术选择会从“这个方法看起来很强”变成“这个方法是否解决了当前问题中最关键的瓶颈”。前者容易被热点牵引,后者才是真正的问题求解。
我之前主要做 navigation,而 REAL-I Challenge 是我第一次尝试 manipulation。这个转变过程的关键,是能不能在短时间内通过高质量的文献调研和问题拆解,把一个新领域的问题结构、方法谱系和关键瓶颈梳理出来。只要问题地图建立得足够清楚,方法选择和实验优先级就会清楚很多。
六、快速探索,然后集中打穿关键点
问题地图建立之后,下一步是快速实验。但快速实验的目的不是把 GitHub 上能跑的模型都跑一遍,而是验证关键假设。
在 ERC 中,我们尝试过 end-to-end learning,也尝试过 classical SLAM + planning。它们不是因为“不够新”或者“不够酷”被放弃,而是因为实验验证了它们在当前约束下的底层假设不够稳。端到端学习需要足够数据支撑泛化,SLAM + planning 需要足够可靠的几何建图和低延迟系统,而这些条件在比赛中都不充分。
在 REAL-I 中也是一样。不同模型路线都可以尝试,但每一次尝试都应该对应一个明确假设:它是否更好地利用了数据?是否减少了过拟合?是否提高了真实部署中的稳定性?是否在分布变化下仍然保持动作质量?如果一个方向失败,最重要的问题不是“再调多少参数”,而是判断失败来自工程实现不充分,还是方法假设与问题约束不匹配。
这类判断非常关键。真实项目和比赛都不允许无限试错。一个方向如果只是细节没做好,就值得继续打磨;如果底层假设不成立,就应该尽早止损。前期可以广泛探索,但后期必须收敛。真正有效的研发节奏,是先用问题导向确定方向,再用第一性原理拆出关键变量,再用实验验证假设,最后把最关键的环节打穿。
七、机器人落地不是方法堆叠,而是约束下的问题求解
连续两年参加 ICRA 全球机器人挑战赛,并且分别在 navigation 和 manipulation 两个方向拿到冠军之后,我最大的感受是:机器人里最稀缺的能力,不是掌握某一个最新模型,而是在复杂约束下判断问题本质的能力。
最新方法当然重要。VLA、Diffusion Policy、SLAM、optimization-based planning、world model、WAM、真机 RL 等都值得认真研究。但在真实任务里,方法本身并不自动产生价值。只有当它击中了当前问题的关键瓶颈,它才有价值。
如果总结成两个层次,就是:
- 从问题出发,而不是从方法出发。先判断任务真正要解决什么,当前约束是什么,失败最可能发生在哪里。
- 用第一性原理拆问题。把目标、输入、数据、误差、约束和可控变量拆清楚,再决定具体方法。