OpenGEN-1:从第一性原理重构 GEN-1
这是一篇从第一性原理出发对 GEN-1 模型的重构,依据来自 Generalist AI 发布的证据、演示、博客,以及 Pete / Andy 的博客和访谈。
核心判断是:
GEN-1 是一个主要基于物理交互流训练出来的物理基础模型,而不是一个从 VLM 改造而来的 VLA。
Pete Florence 和 Generalist 团队明确强调了这个区别:GEN-1 “不是一个把机器人动作硬接到上面的微调版视觉语言模型”,也“不只是一个世界模型” [1]。他们把它称为一个面向物理交互的原生基础模型 [1]。
这个说法很重要。它意味着模型主要学习的不是语言、物体语义,或被动的视频预测。它学习的是物理交互的结构:感知、动作、接触、失败、恢复、速度和后果。
从语义常识到物理常识
在互联网规模数据上训练的 LLM 和 VLM 可以吸收大量语义知识。它们知道苹果是什么,通常是什么颜色,通常在哪里出现,人们通常会对它做什么。
但它们缺少更深层的东西:物理常识 [2]。
如果我把一个苹果向左推,它可能会向左滚。如果前面有一个盒子,它会被挡住。如果我拿着它而它开始滑落,我会收紧手指。这些并不只是视觉事实。它们来自动作及其后果。
Andy Zeng 的文章直接指出了这一点:如果大规模文本带来的是语义常识,那么大规模物理交互也许能够带来物理常识——但前提是数据保留了这个闭环 [2]。
这里有两个层次:
- 前向物理常识:如果我采取这个动作,接下来会发生什么?
- 逆向 / 反射式物理常识:基于当前正在发生的事情,我应该怎么做?
前者接近动力学模型或世界模型。后者更接近策略、逆动力学模型或反射。人类会连续地同时做这两件事。我们并不是先构建一个完美的世界模型,再规划,然后行动。我们是在同一个闭环中感知和行动。
一种流式物理 token 架构
当机器人与物理世界交互时,它接收一连串感知输入,并输出一连串动作。因此,自然的架构不是一个静态的 image-to-action 网络,而是一个流式序列模型。
一种合理的架构是基于物理 token 的 block-causal transformer,其中每个 token 可以是:
- context / task token;
- image token;
- proprioception token;
- force / tactile token;
- action-condition token;
- state-query 或 action-query token。
在推理过程中,模型持续追加 observation chunk,并周期性地解码 action chunk。
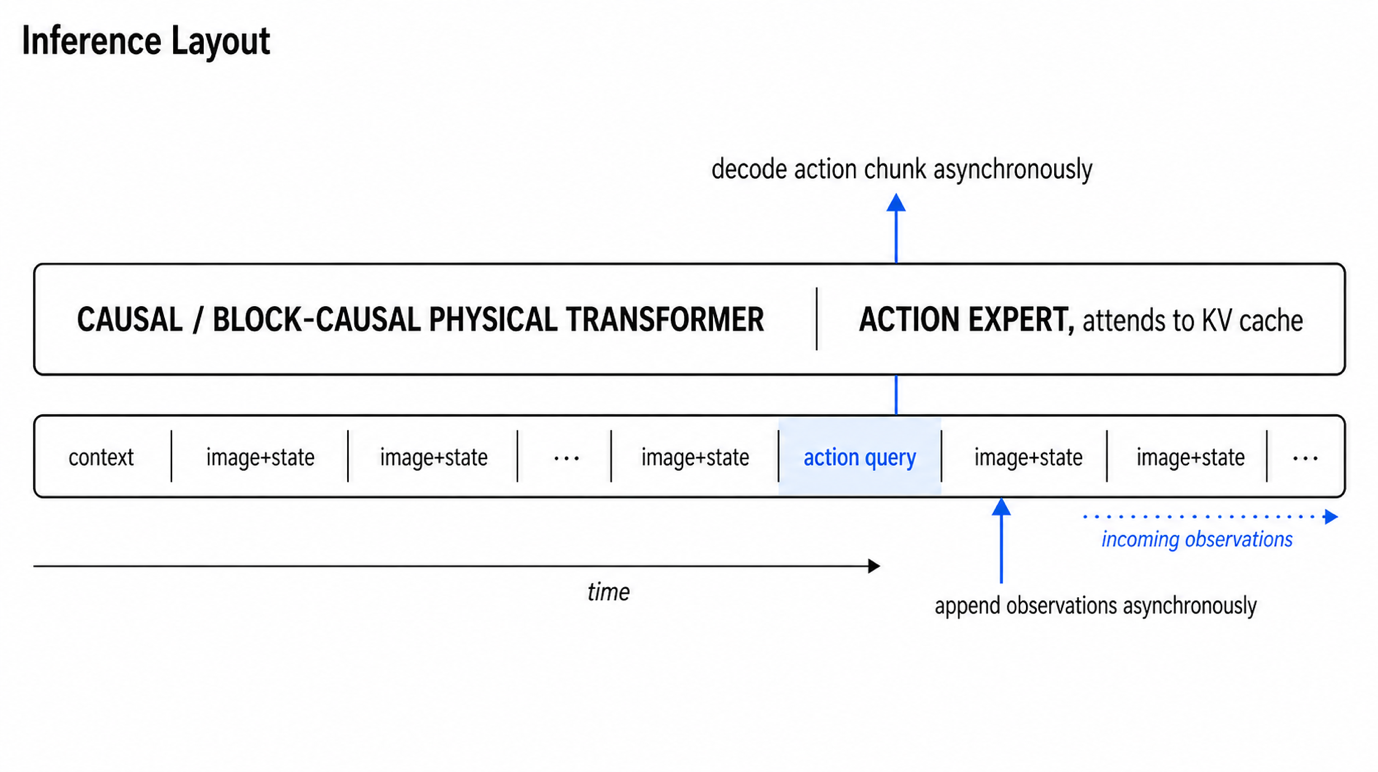
这与 Generalist 自己关于 GEN-0 的描述高度一致。他们把 Harmonic Reasoning 描述为训练模型通过 sensing token 和 acting token 的异步流之间的相互作用来“同时思考和行动” [3]。
过去已处理流的 KV cache 充当短期记忆。更长程的记忆也可能由 harness 管理的 keyframe 或压缩状态摘要提供。Generalist 明确表示,GEN-1 为了实时推理需要“新的 paged attention 形式” [5]。在 transformer serving 中,PagedAttention 本质上就是一种 KV-cache 内存管理方法 [6]。
这也符合 shell-game 演示。该任务需要视觉记忆:在只有腕部摄像头的情况下,物体可能离开视野、被遮挡,或者移动到夹爪后方。只看当前帧的 policy 不够。模型需要基于最近 observation 和 state 的短期工作记忆 [4]。
动作解码可以通过几种方式实现。最简单的是类似 StarVLA-alpha 的直接 action-chunk head [17]。更强的一种选择是 OpenPI 风格的 flow action expert,其中未来动作被表示为连续的 noisy action token,模型从噪声到 clean action 预测一个 vector field [7]。另一种合理选择是类似 GR00T 的 diffusion transformer action module,其中一个快速动作模型基于视觉-语言-本体感知上下文生成流畅的电机动作 [8]。
训练目标:动作预测 + 潜在动力学
标准 VLA 目标是动作预测损失,也就是预测动作和 ground-truth 动作之间的损失,或者在 flow matching 中预测 velocity。
这教会模型逆问题:
给定当前历史,我接下来应该做什么?
但如果要学习物理常识,仅靠动作预测可能不够。模型还应该学习前向问题:
给定当前历史和一个动作,接下来会出现什么物理状态?
这就是世界模型思想有用的地方。但完整 RGB 重建可能太昂贵,而且容易被无关像素细节干扰。模型不需要重建每一个背景纹理。它需要预测与动作相关的物理状态。
更好的目标是 latent future prediction,也就是让预测的未来 latent state 与编码出来的未来 state 对齐。
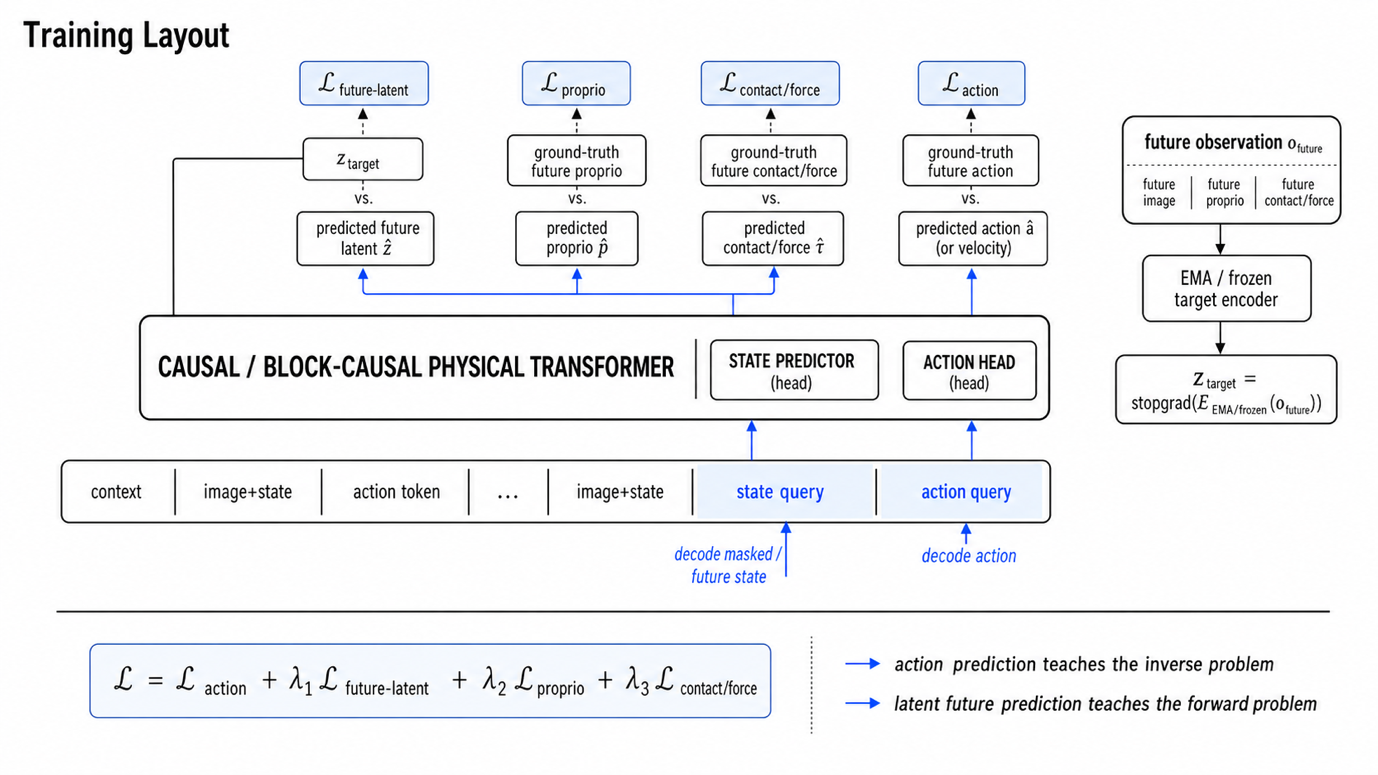
这就是“VLA + world model + beyond”的技术含义。Pete 说 Generalist 花了一年多时间结合“VLAs、world models 以及更多东西”的思想,因为一个模型结合的能力越多,就越难被分类 [1]。
对于 policy inference 来说,如果模型有丰富的 image / proprio history,过去预测过的动作并不是严格必要的。state trajectory 已经包含了它们的大部分效果。但对于 world-model training 来说,干净的 action-condition token 很有用,因为它们可以教会模型因果动力学。
不过,如果 encoder 和 predictor 都可以自由训练,latent reconstruction 可能会 collapse。target latent 应该被锚定:
V-JEPA 风格的方法使用 latent-space prediction、stop-gradient target encoder、masking 和 predictor asymmetry 来避免 collapse [9]。对于物理基础模型来说,action loss 本身也是一个 anti-collapse anchor,因此公式可以更简单。
一个简洁的目标可以写成:
这个目标结合了逆动力学、latent 前向动力学、本体感知预测,以及接触 / 力预测。
物理交互数据
互联网文本和视频可以提供语义先验,但它们不包含完整的物理闭环。大多数互联网视频缺少准确的动作、本体感知、力、抓握、触觉反馈和恢复轨迹。
Generalist 的主张是,可以通过大规模收集物理交互来打破数据瓶颈。GEN-1 使用超过 50 万小时的高保真物理交互数据训练 [5]。更重要的是,它的基础模型不使用机器人数据训练;相反,它使用低成本可穿戴设备采集的人类完成数百万种活动的数据 [5]。
这与 Andy 的数据论点一致。遥操作往往会因为延迟、有限的触觉反馈和不自然的接口而破坏 sensorimotor loop;Generalist 则构建了手持式人体工学设备,让力反馈存在,并让操作者开始“反应”,而不是“思考” [2]。
数据多样性不应该只是语义多样性,也就是不同物体、场景和任务。它还应该包括交互多样性:
- 用力过大 → 物体变形或撞击;
- 用力过小 → 物体滑落;
- 抓取不好 → 重新抓取。
这就是触觉和力数据变得关键的地方。视觉告诉机器人物体在哪里。本体感知告诉它机器人在哪里。触觉和力告诉它实际发生了什么物理交互。
Generalist 的博客称 GEN-1 使用超过 500,000 小时的交互数据训练 [5]。假设数据以 10 Hz 记录:
所以,如果每个 timestep 被压缩成大约 64–256 个 visual token,那么总 token 数大约是 1.15T–4.61T。这里还没有加入 proprioception、action、tactile、force 和 task token。因此,这个数据集已经处于 trillion-token 量级。
与常见 LLM / VLM 对比:
| Model family | Model size | Pretraining tokens | Notes |
|---|---|---|---|
| Llama 2 | 7B / 13B / 70B | 2.0T text tokens | Llama 2 三个尺寸报告的 token 数相同 [10]。 |
| Llama 3 | 8B / 70B | 15T+ text tokens | Meta 报告两个 Llama 3 尺寸都使用 15T+ 预训练 token [11]。 |
| Qwen2-VL | 2B / 8B / 72B | ~1.4T multimodal tokens | Open-Qwen2VL 报告 Qwen2-VL 使用约 1.4T multimodal pretraining tokens [12, 13]。 |
这个数据规模已经足够训练一个 10B 级别的物理基础模型,尤其是因为这些 token 在因果物理信息上非常密集。
这也与 GEN-0 的 scaling observation 一致:Generalist 报告说在约 7B 参数附近出现 phase transition,称 7B+ 模型能更好地内化大规模机器人预训练数据,并指出 GEN-0 已经扩展到 10B+ 的模型规模 [3]。
关键不只是 token 数。1T web token 和 1T physical-interaction token 并不等价。Web token 在语义信息上很密集。Physical-interaction token 在接触、动作、失败、修正、记忆和后果上很密集。
100 Hz 推理需要一个系统
Generalist 早期的 research preview 表示,机器人会把像素和其他传感器数据映射成 100 Hz 动作,并且完整的软硬件栈能够实现反应式、流畅、精确的控制 [16]。
对于一个 10B 模型,使用 fp16 / bf16 时,仅权重就大约是 20 GB。在 batch size 为 1 时,next-token 或 action-query decoding 通常受限于 memory bandwidth。先忽略其他开销。
近似的带宽下界估计:
| GPU | Memory bandwidth | fp16 10B weight-read lower bound | More realistic optimized range |
|---|---|---|---|
| RTX 5090 | ~1.79 TB/s | ~11 ms | ~11–25 ms |
| RTX PRO 6000 Blackwell | ~1.79 TB/s | ~11 ms | ~11–25 ms |
| L40S | 864 GB/s | ~23 ms | ~25–60 ms |
这些只是 weight-read lower bound。真实推理还要支付 KV-cache 读取、vision encoding、action expert steps、kernel overhead、scheduling、robot I/O,以及 safety / control logic 的开销。
因此,可能的设计是:
大模型:
- 以较低 policy frequency 运行;
- 通过 KV cache / paged attention 维护记忆;
- 解码 action chunk;
- 预测或跟踪 latent physical state。
低层 harness:
- 以 100 Hz 执行;
- 混合 action chunk;
- 执行 safety 约束;
- 处理 impedance / force / gripper control;
- 对 tactile 和 proprioceptive events 做出反应;
- 在两次模型调用之间平滑和稳定行为。
这解释了为什么 Generalist 说 GEN-1 更准确地说是一个系统,而不仅仅是一个模型 [5]。
结论
最关键的隐藏洞见是:
GEN-1 不只是一个更好的机器人策略。它是在尝试构建一个面向物理交互的预训练基底。
这与其他 VLA 形成对比。其他 VLA 通常从预训练 VLM 初始化,并使用大量 web data 共同训练模型,从而学习语义常识。而 GEN-1 似乎瞄准的是缺失的那一层:从真实交互的密集流中学习到的物理常识。
Generalist 的演示大多聚焦于展示物理常识上的泛化:接触丰富的操作、遮挡、恢复、流畅性。相比之下,很多 π 系列 / VLM-based robot models 更强调语义或任务层面的泛化:遵循指令、处理未见过的物体,以及跨高层任务描述迁移。
References
[1] Pete Florence and Generalist AI Team, “Going Beyond World Models & VLAs,” Generalist AI Blog, Apr. 7, 2026.
[2] Andy Zeng, “The Dark Matter of Robotics: Physical Commonsense,” Generalist AI Blog, Jan. 29, 2026.
[3] Generalist AI Team, “GEN-0 / Embodied Foundation Models That Scale with Physical Interaction,” Generalist AI Blog, Nov. 4, 2025.
[4] Generalist AI, “GEN-1 Plays the Shell Game,” LinkedIn post, Apr. 2026.
[5] Generalist AI Team, “GEN-1: Scaling Embodied Foundation Models to Mastery,” Generalist AI Blog, Apr. 2, 2026.
[6] Woosuk Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” arXiv, 2023.
[7] Physical Intelligence / Black et al., “π₀: A Vision-Language-Action Flow Model for General Robot Control,” arXiv, 2024.
[8] NVIDIA et al., “GR00T N1: An Open Foundation Model for Generalist Humanoid Robots,” arXiv, 2025.
[9] Meta AI, “V-JEPA: Revisiting Feature Prediction for Learning Visual Representations from Video,” ICLR / OpenReview, 2024.
[10] Meta, “Llama 2 Model Card,” Hugging Face, 2023.
[11] Meta, “Meta Llama 3 8B Model Card,” Hugging Face, 2024.
[12] Wang et al., “Open-Qwen2VL: Compute-Efficient Pre-Training of Fully-Open Multimodal LLMs on Academic Resources,” arXiv, 2025.
[13] Peng Wang et al., “Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution,” arXiv, 2024.
[14] Shuai Bai et al., “Qwen2.5-VL Technical Report,” arXiv, 2025.
[15] Qwen Team, “Qwen2.5 Technical Report,” arXiv, 2024.
[16] Generalist AI Team, “Research Preview,” Generalist AI Blog, Jun. 17, 2025.
[17] Ye et al., “StarVLA-α: Reducing Complexity in Vision-Language-Action Systems,” arXiv, 2026.