Pi 0.6:披着 Reinforcement Learning 外衣的 Supervised Learning
最近拜读了 Pi 0.6 这篇里程碑式的 paper,其中:基于 Reinforcement Learning (RL) 的 Post-training 是实现这一跨越的关键要素。为什么这种形式的 RL Post-training 如此强大?它从根本上改变了我们对大规模 Vision–Language–Action (VLA) 模型训练的哪些认知?
我写这篇文章的初衷,正是为了探究这个问题。具体而言,我想绕开表面上的 RL Formulation,去理解 RECAP 的本质,以及我们应如何思考其进一步的迭代。为此,我发现先退一步,重新梳理整个 Reinforcement Learning 领域的大版图会大有裨益。
梳理过程中我发现:在过去的十年里,Reinforcement Learning——尤其是 Offline RL——一直在稳步向 Supervised Learning 靠拢——有时是显性的,有时则带着厚重的伪装。RECAP 并非这一趋势的例外;在很大程度上,它是这一趋势的巅峰之作。
从经典 RL 到 Supervised Learning:一场渐进式的偏移
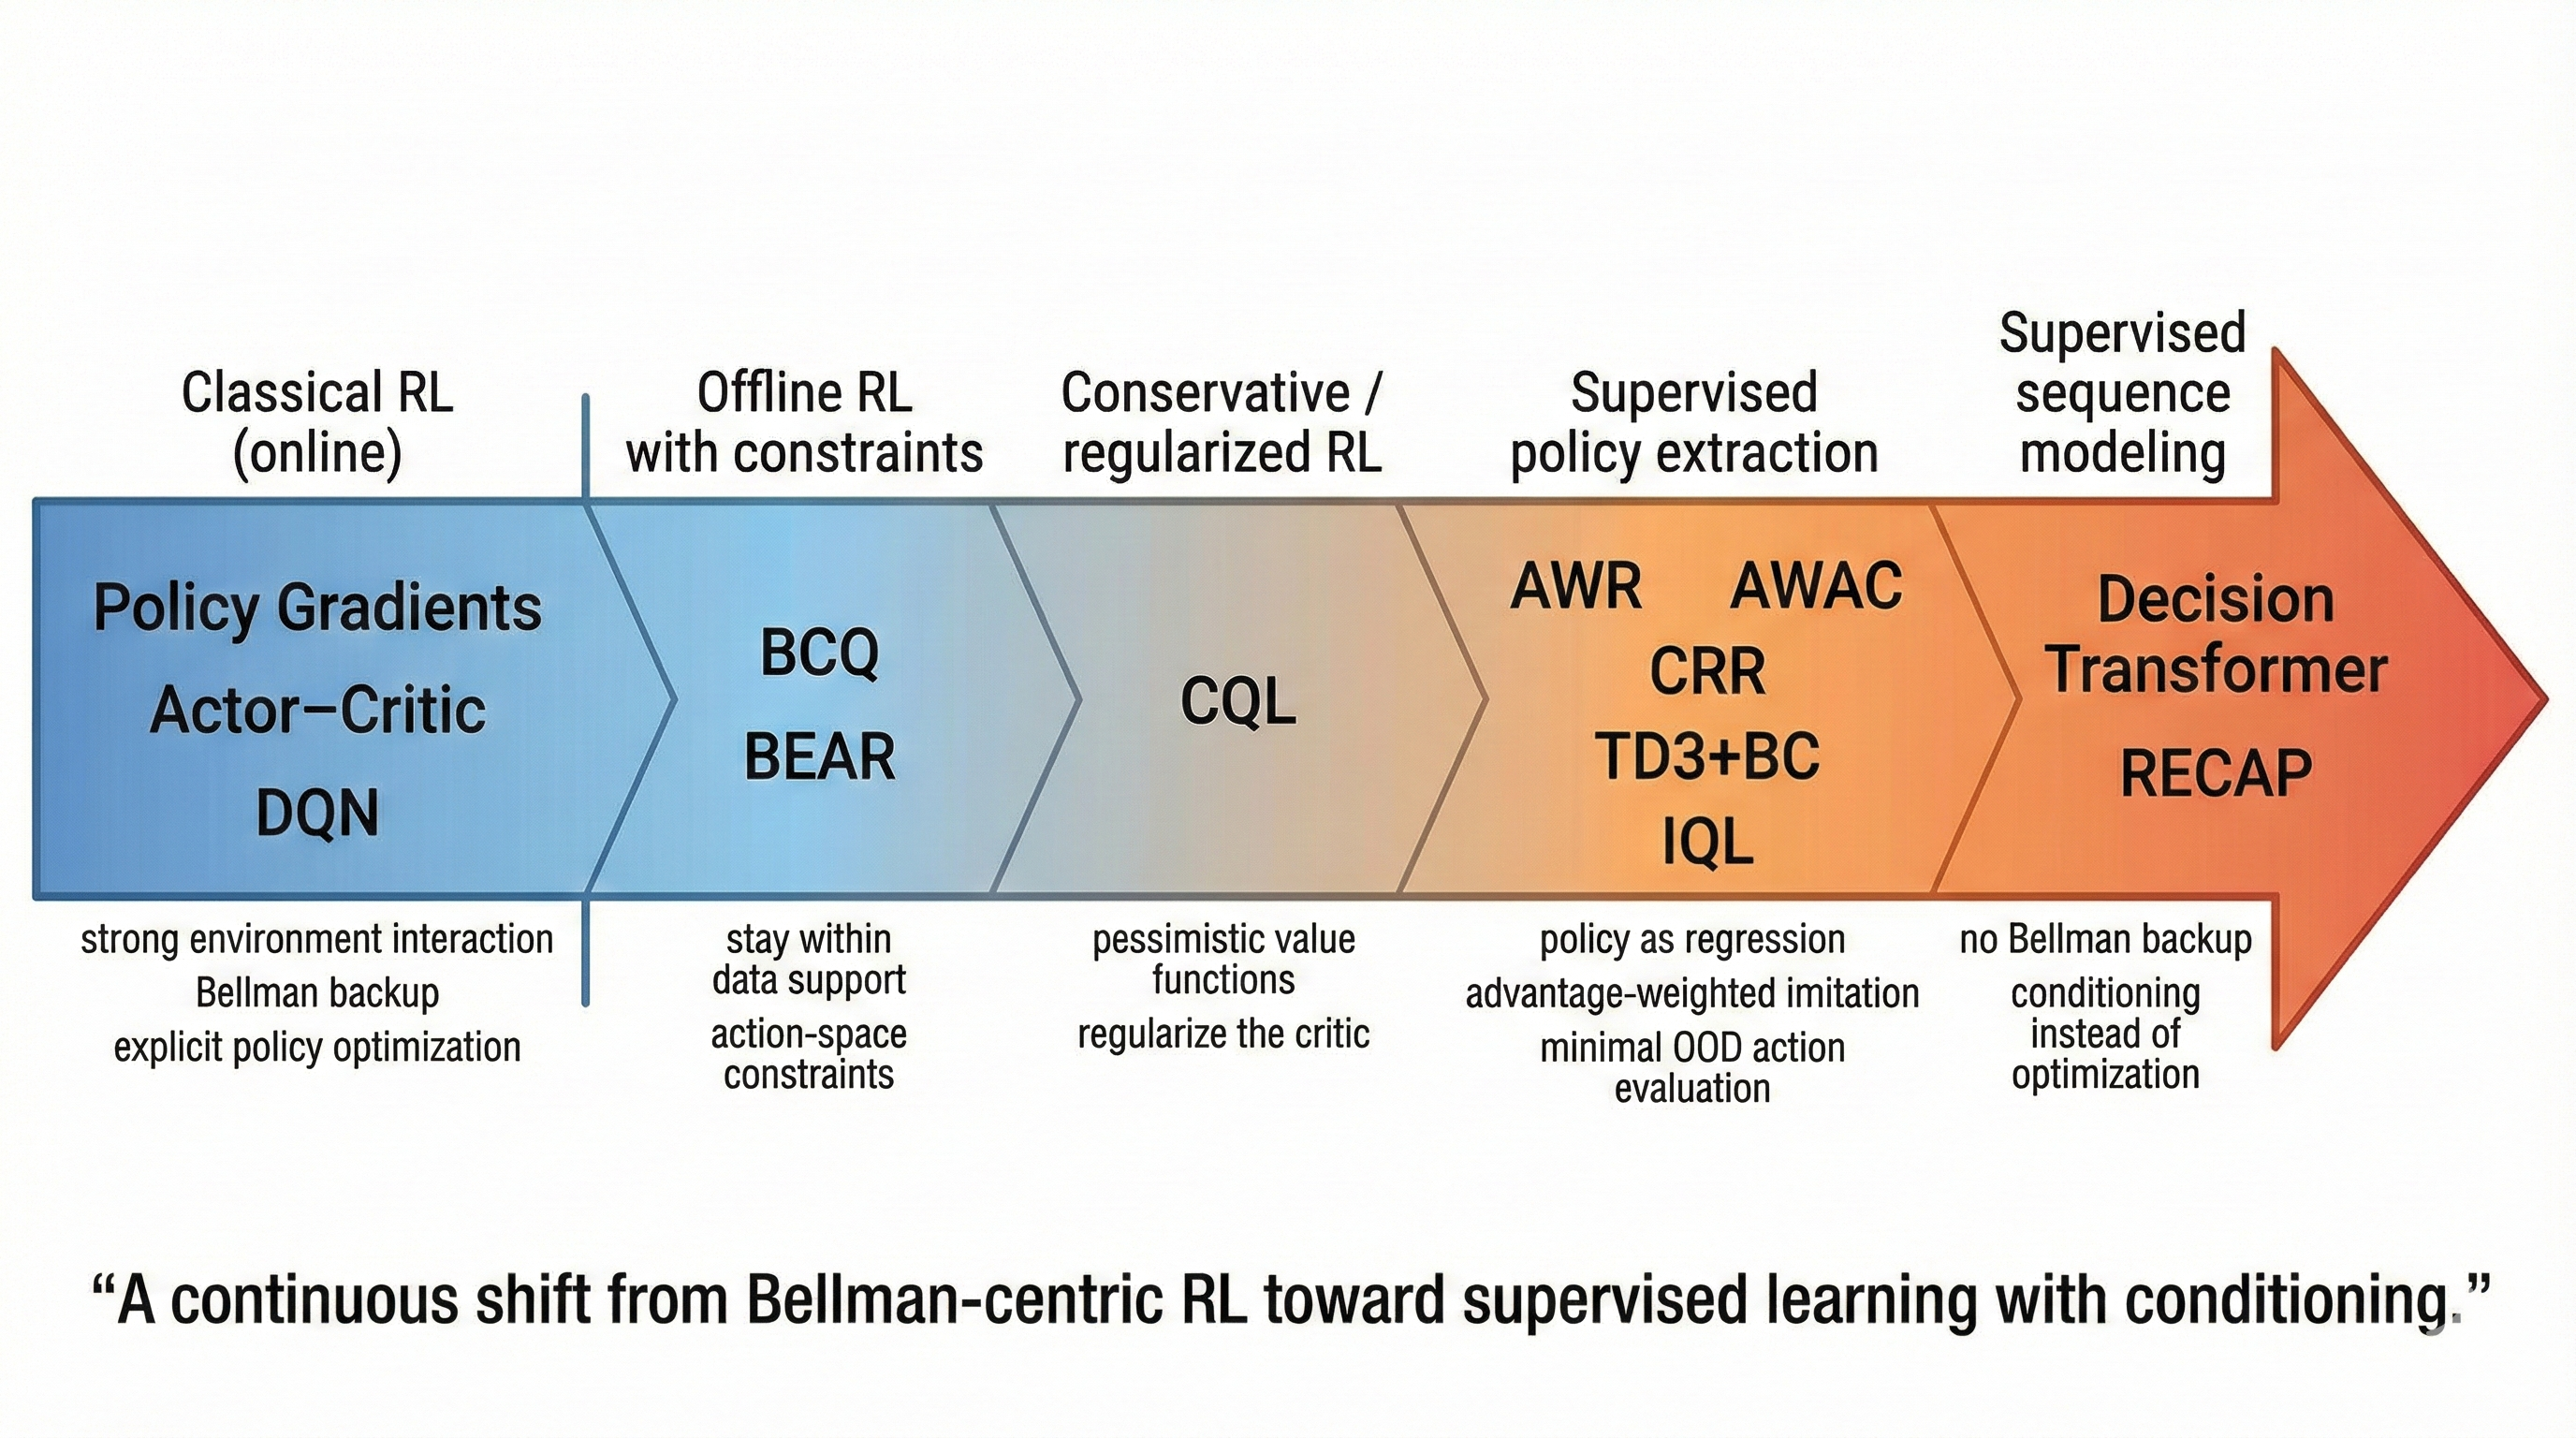
在早期,Reinforcement Learning 与 Supervised Learning 有着界限分明的区别。经典 RL 方法——Policy Gradients、Q-learning、Actor–Critic 算法以及后来的 DQN——都围绕着与环境的紧密交互循环构建。Agent 通过行动收集数据,利用 Bellman backups 估计 Value function,并通过对期望回报的 Gradient Ascent 或对 Q 值的贪婪最大化来改进 Policy。相比之下,Supervised Learning 是对固定数据集的拟合,没有交互、长期 Credit Assignment 或反事实评估的概念。
当研究人员尝试将 RL 应用于交互受限或无法交互的场景时,这种界限开始模糊,从而导致了 Offline RL 的兴起。Offline RL 立即暴露了一个根本问题:Bellman backups 需要评估数据集中从未观察到的动作。这会导致严重的推断误差(Extrapolation Error)和不稳定性,因为 Value function 会给 Out-of-distribution (OOD) 的动作分配任意高的值。
早期的大部分 Offline RL 研究可以被理解为在不放弃经典 RL 框架的前提下对其进行"打补丁"。BCQ 和 BEAR 等方法通过限制 Action Space 或正则化 Policy,使其保持在数据分布附近。随后,CQL 等方法直接在 Value function 中引入保守正则化,使 Critic 对数据集支撑集之外的动作保持悲观。这些方法看起来仍然像 RL——有 Value function、Bellman backups、Critic、Actor——但其目标已经发生了转移:首要任务不再是理论上的最优性,而是保持在 Data Manifold 之内。
随后发生了第二次更深层次的观念转变。许多方法不再直接通过 RL 目标优化 Policy,而是开始将 Policy Improvement 重构为受学习到的 Value 信号引导的数据集监督回归。AWR、AWAC、CRR 和 TD3+BC 都属于这一类。甚至在内部保留了 Bellman 结构的 IQL,也竭尽全力避免对未见动作进行显式评估。Policy 学习越来越像 Supervised Learning,而 Value function 则充当了权重或过滤机制。
最后,随着 Decision Transformer (DT) 等方法的出现,Bellman backup 彻底消失了。Reinforcement Learning 变成了 Sequence Modeling,纯粹以监督目标进行训练,并以 Returns 为条件进行推理。
这种演变绝非偶然。它反映了一个深刻的经验教训:随着模型和数据规模的扩大,Regression 是稳定的,而 Bootstrapping 是脆弱的。
重新审视 Reinforcement Learning:真正重要的是什么?
一旦我们看清了这个模式,自然会问一个更深层的问题:在这一转变中,Reinforcement Learning 有哪些核心要素幸存了下来?
剥离掉历史实现细节,RL 真正贡献的东西只有两点:
- 与环境的交互:这允许模型发现自身的失败模式。
- Value function:它通过引入 Preference 和时间相关性来解决 Multi-modality 问题。
除此之外的一切——Policy Gradients、Q-learning 变体、Bellman bootstrapping——都是可以商榷的。
作为"偏好调节监督"的 Value function
这里需要精确界定:现代系统中所重视的 Value function,不仅仅是任何 Value function,而是一个通过条件调节来解决 Multi-modality 问题的函数。
在许多现实任务中,动作分布具有固有的 Multi-modality。以抓取杯子为例:存在多种有效的抓取方式、轨迹和风格。如果我们简单地用 Supervised Learning 来学习完整的动作分布,采样会变得不稳定且往往缺乏连贯性。一个天真的解决办法是将数据集压缩为专家演示,但这会引入严重的偏见和脆弱性——一旦 Policy 偏离了专家流形,它就会进入一个 OOD 状态。
Value function 提供了一个不同的方案。我们不压缩数据,而是保留所有轨迹(成功的、部分成功的和失败的),并引入一个信号,根据长期期望值将动作关联起来。从这个意义上说,Value function 充当了一个潜在的 Preference 变量。它允许我们从多样化的数据集中采样"良好"的行为,而不会破坏这种多样性。
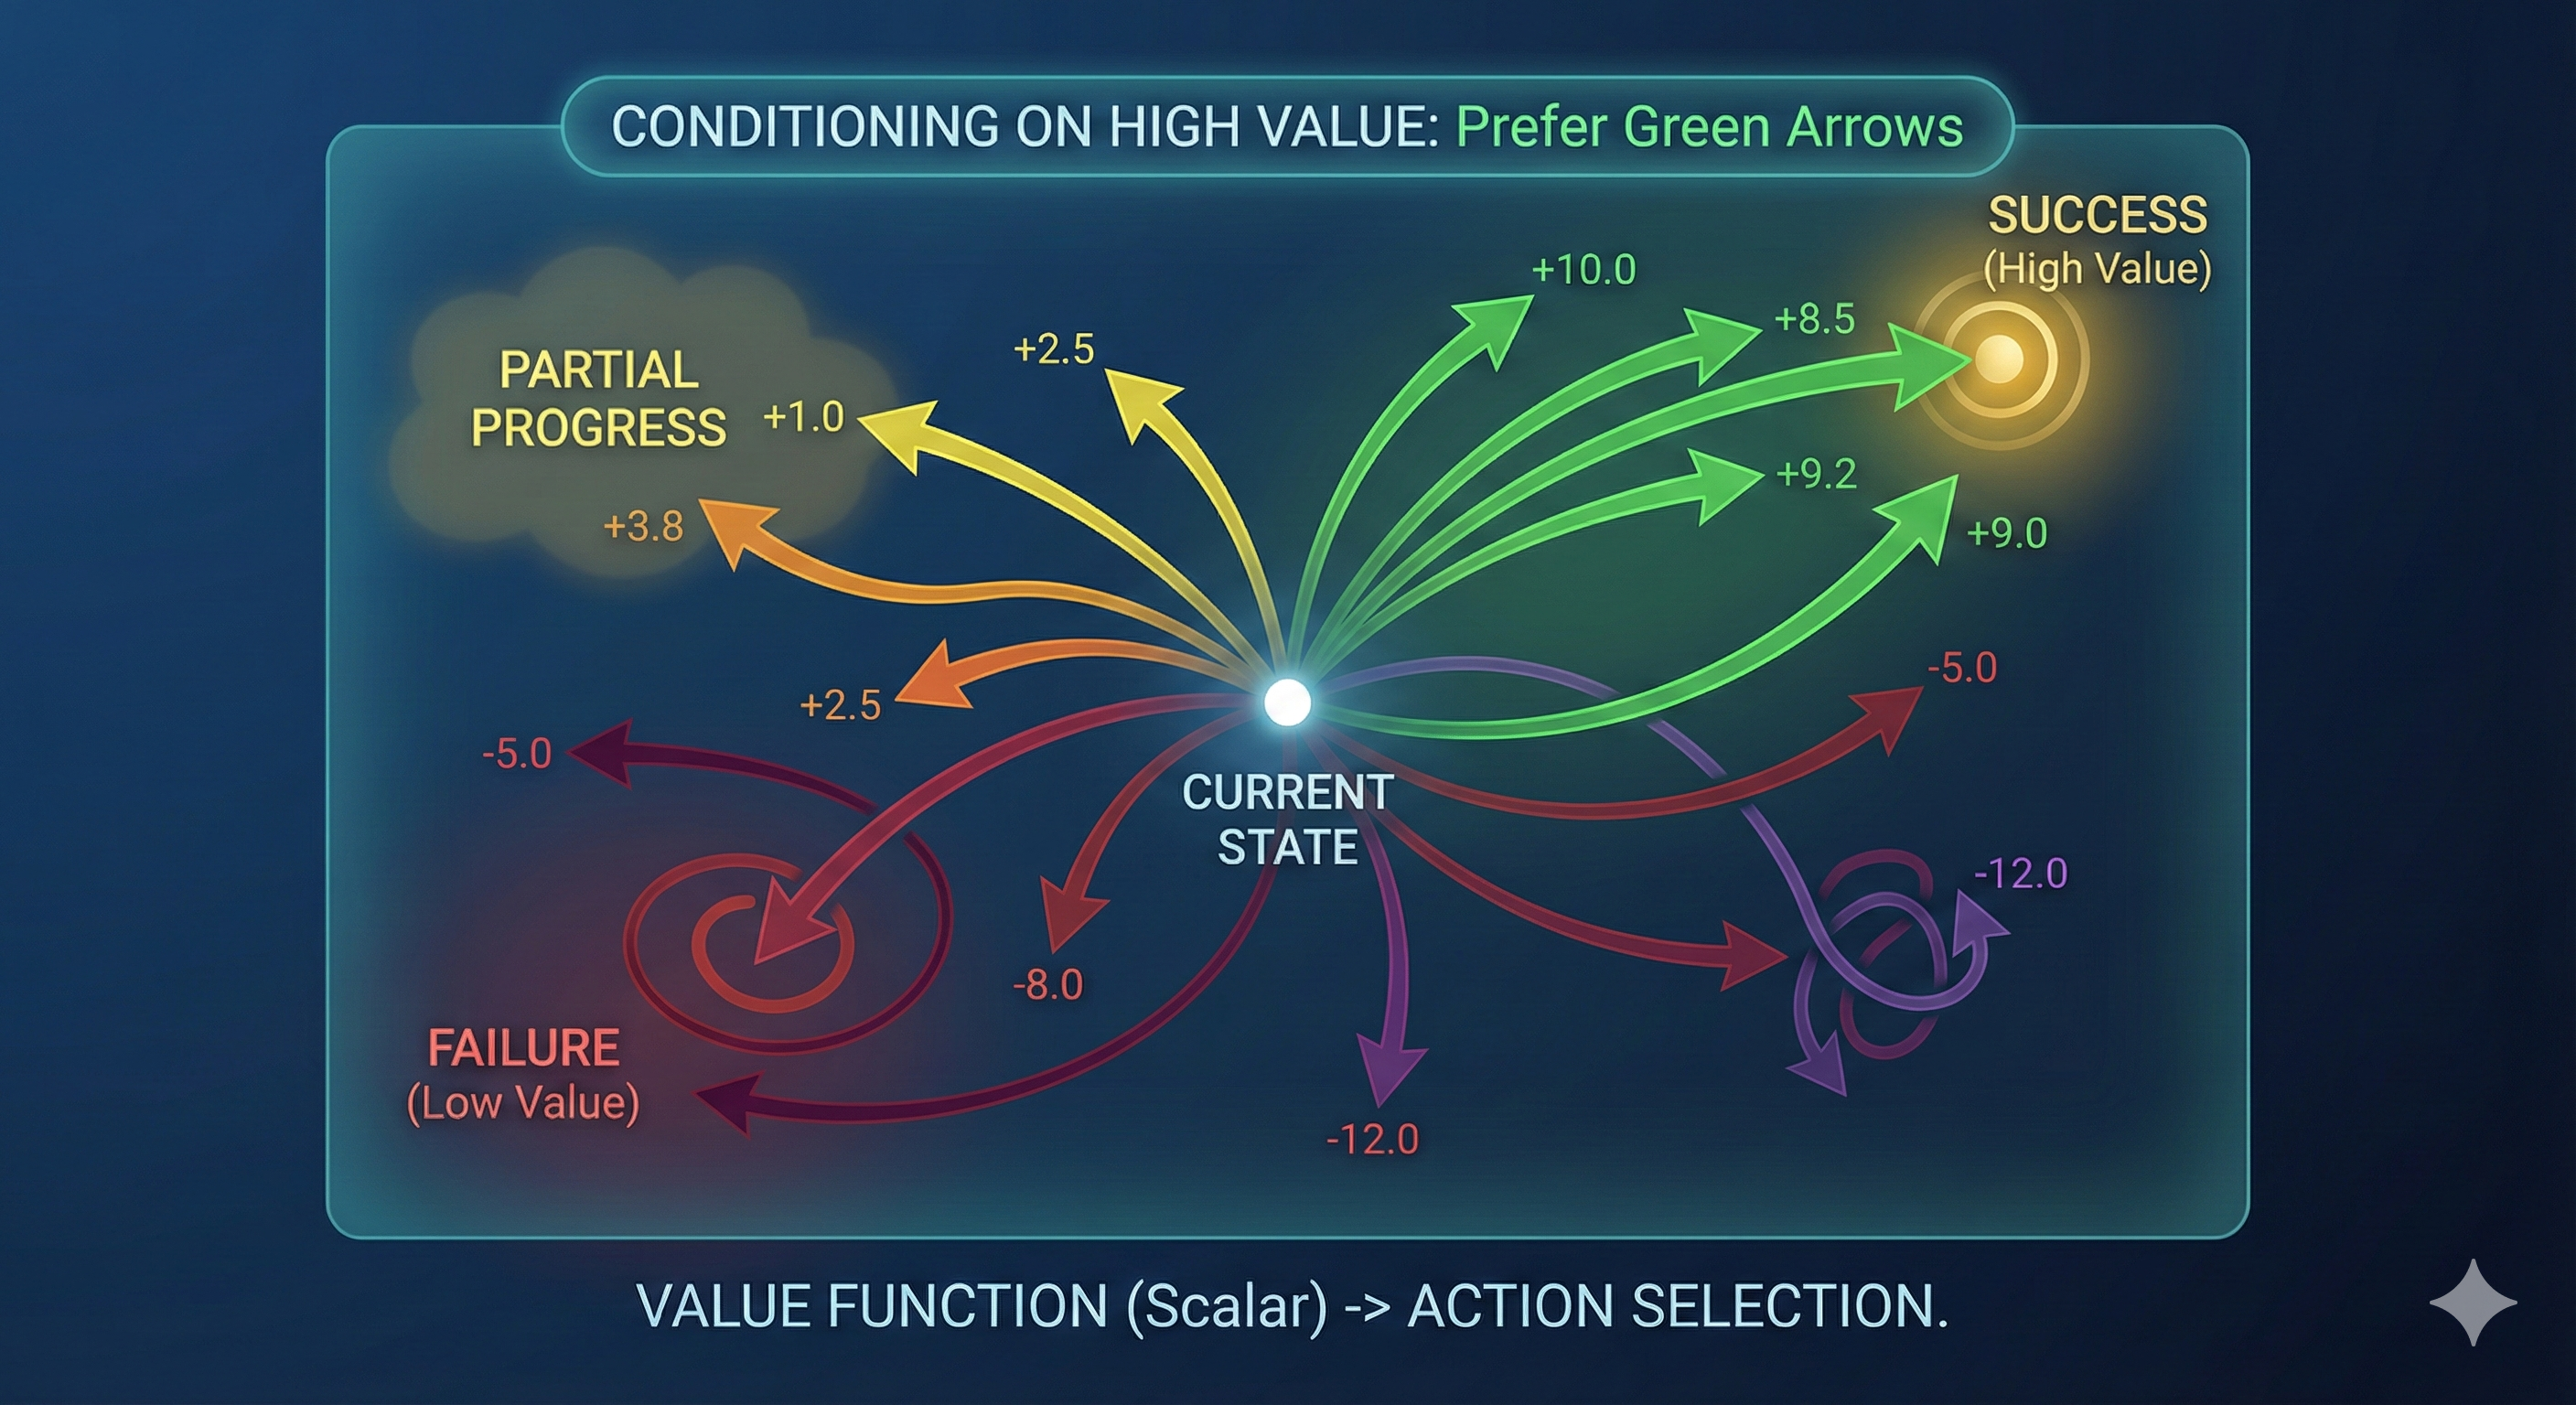
这种构架立即将我们引向了现代大语言模型 (LLM) 的训练。当我们提示 LLM"写得专业一点"或"简洁一点"时,我们就是在以潜在 Preference 变量为条件进行生成。RLHF 通过 Reward Models 将这一过程形式化;Preference Optimization 和 Post-training 将生成偏向于高奖励的输出。
Decision Transformer 通过以 Return-to-go 为条件做了同样的事情。RECAP 则以从学习到的 Value function 中导出的"最优性指示器"为条件。其机制是相同的:由 Preference 信号引导的 Supervised Learning。
有趣的是,现在的这种融合是双向的。机器人领域越来越多地借鉴 LLM 式的条件调节和 Preference 建模,而 LLM 自身也越来越依赖 RL 式的 Post-training 来精炼行为。这两个社区正在中途相遇。
环境交互:增加样本覆盖
RL 第二个幸存的要素是与环境的交互。无论多大的固定数据集,都无法预见所有的失败模式。部署后的 Policy 最终会遇到表征不足的状态,并犯下系统性错误。
交互通过揭示模型的错误所在来解决这一问题。这个想法早于现代 RL——DAgger 算法已经证明了 Imitation Learning 必须是迭代的——但 RL 增加了一个关键点:一种赋予失败以意义的标注方式。
当与 Value function 结合时,交互变得极其强大。失败的轨迹不再是无用的垃圾,它们变成了负标签样本。局部进展仍然携带学习信号。交互产生多样化的数据;Value function 将这些数据转化为结构化的监督信号。
同样的模式也出现在 LLM 的 Post-training 中:部署、观察失败案例、收集 Preference 反馈、重新训练。再次体现了:交互 + Value。
RECAP:披着 RL 外衣的 Supervised Learning
沿着上述轨迹,我们可以清晰地发现:RECAP 的本质不应被理解为回归经典 Reinforcement Learning,而是一个从根本上植根于 Supervised Learning、并辅以少量精选 RL 要素的系统。
尽管 RECAP 有着基于 RL 的推导过程,但其操作现实非常简单:
- Policy 通过对数据进行监督回归来训练。
- Value function 通过对回报进行监督回归来训练。
- 没有 Bellman bootstrapping,没有 Policy Gradient,也没有对动作空间的显式优化。
性能的提升并非来自传统意义上求解 RL 目标函数,而是源于在一个强大的监督模型上,以学习到的 Preference 信号进行条件调节。
从这个意义上说,RECAP 离 Supervised Learning 比离经典 RL 近得多。它的成功主要取决于治理大规模监督系统的相同因素:数据的质量、多样性和覆盖范围;模型的容量和归纳偏置;以及训练目标的稳定性。这些因素对性能的主导作用远超 RL 公式中任何细微的数学属性。
剩下的 RL 组件并不是优化的引擎,而是结构化工具。Value function 提供了一种在 Multi-modality 动作分布上施加 Preference 和时间相关性的方法。与环境的交互提供了一种发现失败模式并扩展数据集的机制。两者结合,引导了 Supervised Learning,而非取代它。
RL 还能贡献什么——以及改进的方向
将 RECAP 视为核心上的 Supervised Learning 并不是对 Reinforcement Learning 的否定。相反,它理清了 RL 思想在哪些方面仍然重要,以及在哪些方面应用最为高效。
一个重要的贡献在于 Value function 是如何被学习的。即使通过 Regression 训练,Value 估计仍然受制于经典的 RL 权衡:variance bias trade-off、Horizon Length 以及对分布偏移的敏感性。RL 领域开发的技术——如方差削减、多步估计或不确定性感知 Critic——对于提高调节信号的质量和可靠性仍然高度相关。
另一个关键领域是如何利用 Value 信号来调节 Policy。RECAP 目前依赖于 binary optimality indicator,这优先考虑了鲁棒性和简单性。虽然在许多情况下有效,但这不可避免地丢弃了信息。在具有微妙权衡、长程依赖或噪声 Value 估计的场景中,硬阈值可能会变得脆弱或产生误导。在这里,来自 Offline RL 的想法——如软优势加权、校准 Preference 评分或不确定性感知调节——提供了清晰的改进路径。
总结展望
这回到了本文的初衷:理解 RECAP 到底是什么,为什么它有效,以及如何思考它的改进。我认为答案是:RECAP 代表了一个成熟的收敛点。它提取了 Reinforcement Learning 中能够规模化扩展的部分——交互和基于 Value 的条件调节——并将它们嵌入到一个稳定、极具表现力且数据驱动的 Supervised Learning 框架中。
以这种方式理解 RECAP,使我们能够同时运用两种视角进行分析。在设计模型、数据集和损失函数时,我们可以运用 Supervised Learning 的直觉;同时仍然借鉴 Reinforcement Learning 理论来思考 Value 估计、Preference 信号和长程结构。这种结合不仅不是矛盾,反而正是 RECAP 等方法如此有效的核心所在。
从这个意义上说,RECAP 并不是将 Reinforcement Learning 隐藏在 Supervised Learning 之后,而是向我们展示了:当 Reinforcement Learning 被蒸馏到只剩下真正核心的精华时,它看起来到底是什么样子。
接着上一篇,为了仔细理解 RL post training,仔细读了 pi0.6 这篇文章,顺带 review 梳理了一下最近 RL 的发展轨迹,发现很有意思的现象:就是 RL 在往 supervised learning 上面靠,当然反之亦然(双向奔赴了这是)。这不只是这一篇的结论,而是整个发展轨迹都是如此。一句话说,就是把 RL 核心思想用 SL 的方式来解决。这个趋势发展感觉 Richard 前辈也会满意了。