说 VLA 已死,为时过早
这篇 DreamZero / WAM 论文最重要的点,不是“机器人会生成视频了”,而是它把 robot policy 重新拆成了两个问题:先预测未来会发生什么,再从这个未来反推出动作。
论文 Eq. 1 已经把结构写得很清楚:
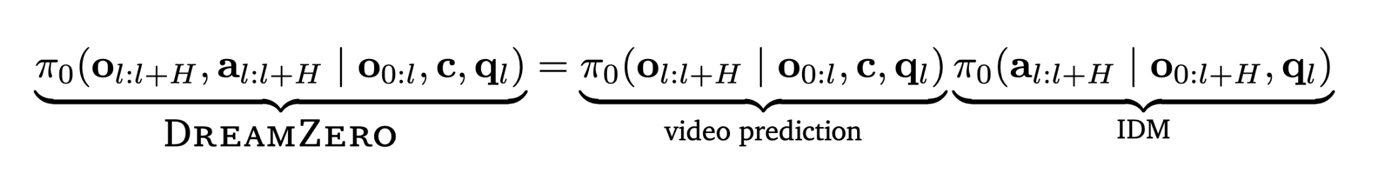
先生成 future video,再在这个 future video 上生成 action。也就是说,WAM 的本质是:显式 forward dynamics model + IDM。
它不是传统 VLA 那种从 VLM 接一个 action head,直接做 image / language → action。它先生成 future video;再让 inverse dynamics model 根据这个 future state 生成动作。future video 在这里扮演的是 visual plan。IDM 做的事情,是把这个 visual plan 翻译成 robot action。
这个区别非常关键。
为什么 WAM 在数据上更占便宜
VLA 的预训练主要来自 image-text / VLM 数据。它学到的是语义常识:
- 这个东西是什么?
- 这句话是什么意思?
- 这个目标大概在哪里?
但机器人真正缺的不是这个,而是:这个动作做下去,物理世界会怎么变?
WAM 的 advantage 在这里。
video generation backbone 本身就预训练在大规模视频上。视频天然包含时间、运动、接触、遮挡、变形、因果演化。虽然互联网视频没有 robot action label,但它至少和机器人最终要预测的东西高度对齐:都是物理世界的状态序列。
所以 robot data finetune 的阶段,本质不是从零学物理,而是让一个已经见过大量世界演化的视频模型,学会:
- 这个 embodiment 怎么和世界互动;
- 这个 future visual trajectory 对应什么 motor command。
相比之下,VLA 的 VLM pretraining 和 robot action prediction 是错位的。image-text data 对“语义”很强,但对“动作序列的物理演化”并不直接对齐。
这也是为什么 WAM 能更好吃下 diverse、non-repetitive robot data。对于 VLA,同样一段杂乱 robot trajectory 可能只是 noisy state-action pairs。对于 WAM,每一段连续视频都是 dense future-state supervision。
这不是小差别,这是数据利用方式的差别。
为什么 IDM 比直接学 VLA policy 更好学
直接 VLA policy 要一次性学两个东西:
- 未来应该发生什么;
- 机器人该怎么动才能让它发生。
WAM 把问题拆开:
- video model 负责预测 future state;
- IDM 负责把 future state 映射成 action。
这会让 action learning 更像一个逆动力学问题,而不是端到端硬拟合 policy。
论文里也给了很强的信号:很多失败主要来自 video prediction error,而不是 action extraction error。换句话说,只要未来视频预测对了,IDM 往往能比较稳定地把动作拉出来。
这说明 WAM 的瓶颈很可能已经从“动作头会不会学”转移到了“世界模型能不能预测对”。这也是为什么它在 unseen task 和 cross-embodiment 上效果好,是合理的。
为什么 unseen task / cross-embodiment 结果 make sense
对于 unseen task,VLA 如果没在 robot data 里见过类似动作,它只能靠 VLM 的语义 prior 硬猜。但 VLM 没有大规模动作序列预训练,它并不知道“解鞋带”“熨衣服”“握手”这种物理 motion 应该如何展开。
WAM 不一样。
它可以先用 video generation backbone 生成一个 future visual plan。这个 video backbone 很可能在大规模视频里见过类似的动作演进。然后 IDM 再把这个 visual future 转成 robot action。
所以 WAM 在 unseen task 上比 VLA 好,不神秘。
cross-embodiment 也是一样。如果一个 human 或另一个 robot 的 video-only demo 能帮助 WAM 更新“这个任务的视觉演化”,那它不一定需要 action label。因为 action label 是 embodiment-specific 的,但 future visual state 更接近 embodiment-agnostic。
这就是 WAM 最有价值的地方:它把大量没有 robot action label 的视频数据,变成了可以影响 policy 的训练信号。
这是 VLA 很难直接做到的。
但代价也很大
WAM 的强,来自显式 world modeling。但显式生成 future video 不是免费的。
它需要模型真的理解多出来的世界演化信息。这就吃 model capacity。
Table 4 里这个点非常明显:
5B DreamZero 只有 21% task progress;14B DreamZero 到 50%。
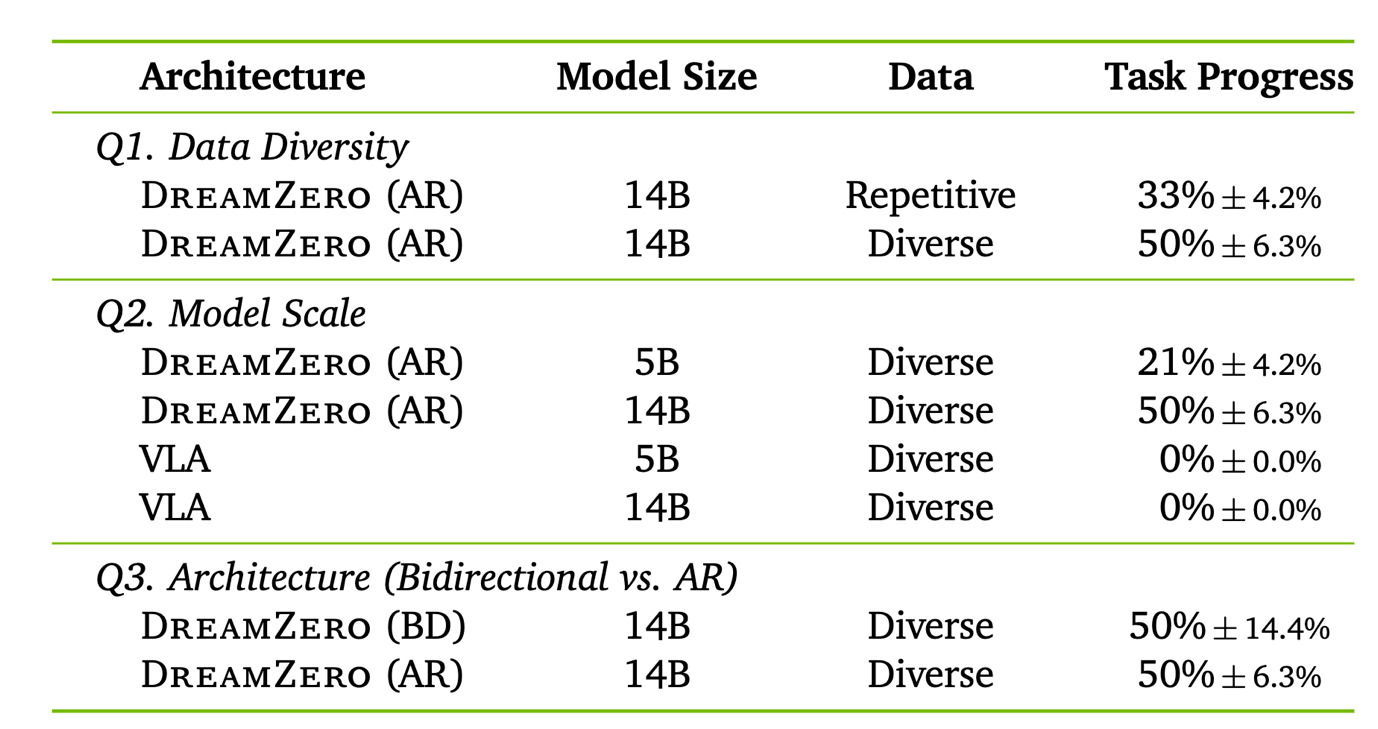
小模型扛不住显式 video generation + action alignment,容易 hallucinate future,然后 action 也跟着错。
所以 WAM 是一个把 world model 放进 policy 里的大模型系统。这和很多 VLA 的工程属性不一样。VLA 可以更便宜、更快、更容易部署;WAM 则把更多能力前置到了 video generation backbone 里。
真正尴尬的是工业落地
如果只看 zero-shot / low-shot,WAM 很漂亮。但如果你真要落地到工厂、仓库、餐饮、家庭服务,一个绕不开的问题是:
最终还是要 post-train。
Figure 10 很值得细看。
在 shirt folding 上,33 小时 post-training data 之后,DreamZero 和 pretrained VLA 基本打平,都是 92.5%。在 fruit packing 上,12 小时 post-training data 之后,DreamZero 到 96%,明显强于 VLA。
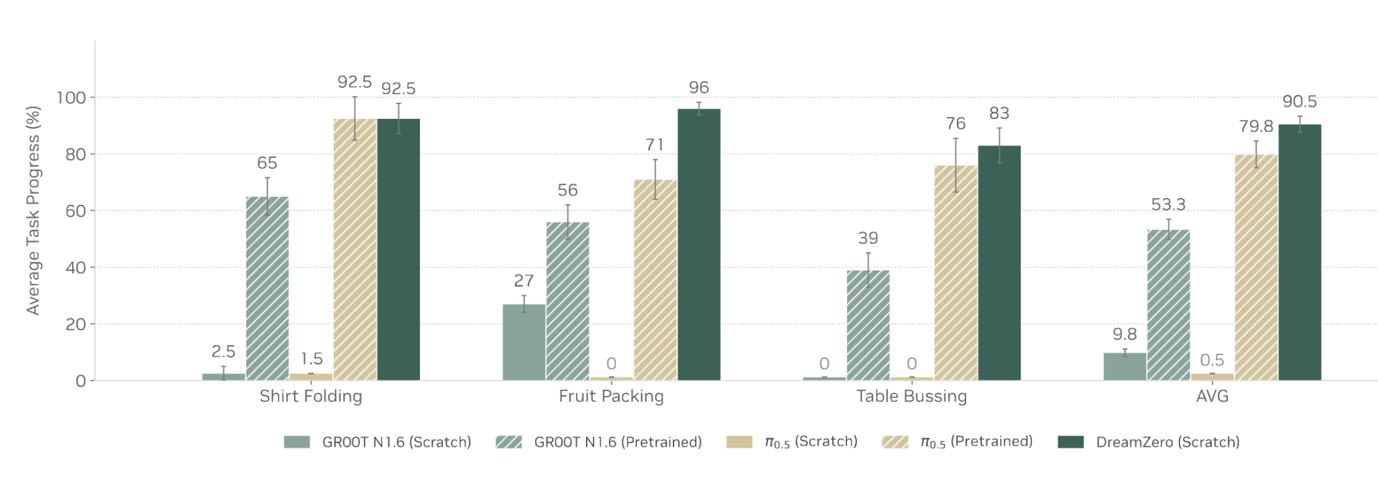
这就带来一个很尴尬的 tradeoff:
少量数据时,WAM 确实比 VLA 更强,但可能还没强到足够稳定落地;数据加多之后,WAM 和强 VLA 的差距又可能缩小;但 WAM 的推理成本、延迟、系统复杂度明显更高。
论文自己也承认,DreamZero 要靠一整套系统优化,把 14B autoregressive video diffusion model 从 5.7 秒优化到 150 ms,并且使用 2×GB200 才跑到 7 Hz。一台 GB200 的成本在 50 万元以上,而且需要直接液冷(DLC)系统。与此同时,当前 VLA 可以在 consumer GPU 上跑到 20 Hz+。
这不是小工程差距。这是部署成本差距。
所以,如果一个工业任务本来就可以收几十小时高质量数据,VLA 便宜、快、稳定,可能依然是非常强的 baseline。
WAM 的优势更像是:
- 长尾任务;
- unseen motion 及低重复示教下的泛化;
- cross-embodiment transfer;
- video-only data 利用。
而不是所有场景直接替代 VLA。
我的判断
WAM 是一条非常重要的路线。它的核心贡献不是“机器人生成视频”,而是证明了:
video generation backbone 可以作为 robot policy 的物理先验。
这条路线比传统 VLA 更接近物理世界的演化结构,也更能利用大规模视频数据。它让 robot learning 从“直接拟合动作”变成了“先理解未来,再反推动作”。
这很强。但说 VLA 已死,为时过早。
VLA 的问题是物理泛化弱;WAM 的问题是成本、延迟、容量和部署复杂度高。
一个更现实的判断是:
WAM 会在 unseen task、low-shot、cross-embodiment 和 video-data scaling 上打开新上限;但在大量工业场景里,VLA 仍然会因为便宜、快、易部署而活得很好。
WAM 证明了 VLA 的上限问题。但它还没有证明 VLA 的工程价值已经消失。
所以,VLA 没死。只是以后不能再只靠 VLM pretraining 讲 robot foundation model 的故事了。